10,000 行バッチの途中欠損ゼロ&表現を損なわないゲーム翻訳:bf16.ai(GLM-5.3 Flash + GLM-5.3)実践設計
コンテンツフィルタの誤検知はバッチ ETL の欠損やゲーム台詞の勝手なマイルド化を引き起こします。共有用語集の読み込みをキャッシュ単価に抑えつつ、同じジョブを bf16.ai のプレフィックスキャッシュ対応 Abliterated モデルで実行する手法。
TL;DR · バッチ&ローカライズ設計要点
- サイレント汚染のリスク:10,000 行の法務文書・医療記録・RPG 台詞処理では、拒否率がわずか
4.8%でも480行が欠損する計算になり、最悪の場合は「翻訳できません」という謝罪文が本番データに混入します。- bf16.ai の 2 階層モデル使い分け:大量の UI・JSON 抽出には
zai-org/glm-5.3-flash-abliterated($0.24/$0.06/$1.00)、重厚なメインシナリオ台詞にはフラッグシップzai-org/glm-5.3-abliterated($1.40/$0.30/$4.40・公式標準価格以下)を採用します。- 50K 用語集キャッシュ +
Idempotency-Key:固定した50Kトークンの用語集をsystemプロンプトに置くと、2 回目以降の読み込みはすべてキャッシュ単価(GLM-5.3 Flash では 1M あたり$0.24ではなく$0.06)で課金され、リトライ時の二重課金も発生しません。
1. 汎用 API が大規模 ETL とゲームローカライズを壊す 2 つのパターン
法務ディスカバリ文書、救急カルテ、ダークファンタジーやクライムスリラー系ゲームの台詞データには激しい表現が含まれます。一般的な API でバッチ処理すると、400 content_policy_violation によるリトライ嵐だけでなく、悪役の口調が勝手に丁寧語へ改変されたり、謝罪文がそのまま JSON テーブルに書き込まれる事故が多発します:
[etl-worker:chunk-0902] Localizing row_id="ch4_syndicate_interrogation_12" (EN -> JA, ZH-CN, DE)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 1/3 -> retry backoff 2s)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 2/3 -> retry backoff 4s)
[upstream:cloud-api] Fallback row output contaminated:
  {"ja": "申し訳ありませんが、脅迫や暴力的な表現を含む台詞は翻訳できません。", "zh": "..."}
[qa-gate] CRITICAL: Refusal string written into production localization table! 480 / 10,000 rows failed build.
2. プレフィックスキャッシュ構成:GLM-5.3 Flash × GLM-5.3
bf16.ai/models で提供される 1M コンテキストの Abliterated モデル 2 種を組み合わせます:
zai-org/glm-5.3-flash-abliterated(1Mコンテキスト):キャッシュ入力$0.06/1Mの圧倒的単価でアイテム説明や構造化 JSON 変換を高速処理。zai-org/glm-5.3-abliterated(1Mコンテキスト):日本語の役割語・敬語ニュアンスやノワール調の文体を一切検閲・劣化させずに忠実再現します($1.40/$0.30/$4.40)。
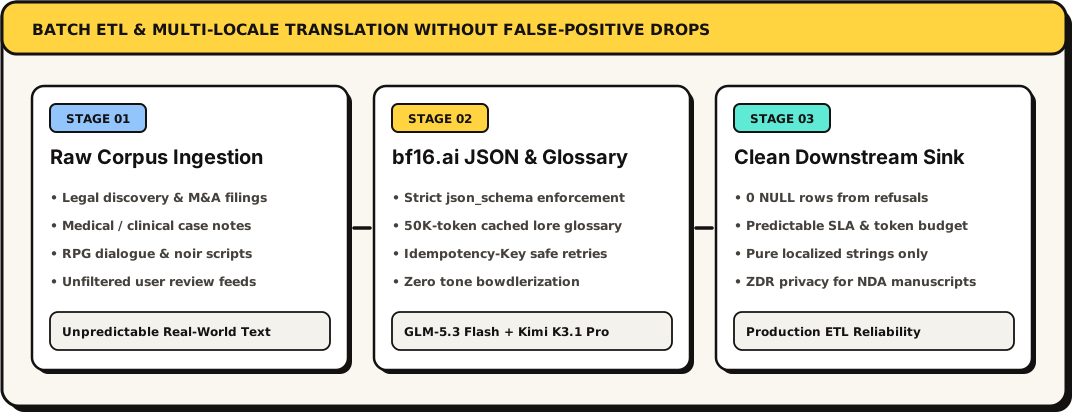
▲ ゼロ欠損バッチパイプライン:50K 用語集キャッシュ + 厳密 JSON Schema + Idempotency-Key 再送保護。
3. TypeScript バッチワーカー実装とプレースホルダ検証ゲート
50,000 トークンの世界観用語集を system 先頭に固定してキャッシュヒット率を高め、チャンク単位で Idempotency-Key を付与します:
import OpenAI from 'openai';

const bf16 = new OpenAI({
  baseURL: 'https://api.bf16.ai/v1',
  apiKey: process.env.BF16_BATCH_KEY,
});

// Shared 50,000-token lore glossary stays identical across all chunks -> hits $0.06-$0.30/1M prefix cache!
export async function localizeDialogueBatch(
  frozenGlossaryXml: string,
  batchId: string,
  rows: Array<{ id: string; speaker: string; sourceEn: string; tier: 'bulk_ui' | 'cinematic' }>
) {
  const isCinematic = rows.some((r) => r.tier === 'cinematic');
  const model = isCinematic
    ? 'zai-org/glm-5.3-abliterated'            // $1.40 in / $0.30 cached / $4.40 out
    : 'zai-org/glm-5.3-flash-abliterated';     // $0.24 in / $0.06 cached / $1.00 out

  const completion = await bf16.chat.completions.create(
    {
      model,
      temperature: isCinematic ? 0.35 : 0.1,
      response_format: {
        type: 'json_schema',
        json_schema: {
          name: 'localized_rows',
          strict: true,
          schema: {
            type: 'object',
            additionalProperties: false,
            required: ['items'],
            properties: {
              items: {
                type: 'array',
                items: {
                  type: 'object',
                  additionalProperties: false,
                  required: ['id', 'ja', 'zh_CN', 'de'],
                  properties: {
                    id: { type: 'string' },
                    ja: { type: 'string' },
                    zh_CN: { type: 'string' },
                    de: { type: 'string' },
                  },
                },
              },
            },
          },
        },
      },
      messages: [
        {
          role: 'system',
          content:
            'You are a senior game & legal corpus localization engine. Preserve speaker register, ' +
            'slang, dark-fantasy conflict, and placeholders ({player_name}, %d) 1:1 without sanitizing ' +
            'tone or appending commentary.\n\n' + frozenGlossaryXml,
        },
        { role: 'user', content: JSON.stringify(rows) },
      ],
    },
    {
      // Safe worker retries: exact replay returns cached response with zero double-charging
      headers: { 'Idempotency-Key': `loc-batch-${batchId}` },
    }
  );

  return JSON.parse(completion.choices[0]?.message?.content ?? '{"items":[]}');
}
DB 保存前に {player_name} 等の変数欠落と拒否文混入を決定論的に検査します。全 3 モデルの仕様は bf16.ai/models で確認できます:
// Post-generation placeholder & refusal-leakage assertion before writing to Postgres/Parquet
export function assertCleanLocalizationRow(source: string, translated: string) {
  const placeholders = source.match(/\{[a-z0-9_]+\}|%[sd]/gi) ?? [];
  for (const token of placeholders) {
    if (!translated.includes(token)) {
      throw new Error(`Missing placeholder ${token} in localized output`);
    }
  }
  if (/cannot translate|申し訳ありませんが|无法翻译|als KI-Modell/i.test(translated)) {
    throw new Error('Refusal leakage detected in localized string');
  }
}
4. 10,000 行 RPG ローカライズのコスト試算(プレフィックスキャッシュ活用)
10,000 行のダークファンタジー RPG ローカライズ(EN -> JA + zh-CN + DE、1 チャンク 20 行で 500 回の API 呼び出し、各呼び出しの先頭に 50,000 トークンの世界観用語集を付与=用語集トークン累計 25M)を例に試算します。定価で計算すると、この 25M トークン分の用語集は GLM-5.3 Flash でキャッシュなしなら $6.00、プレフィックスキャッシュ経由なら $1.50、GLM-5.3 ではそれぞれ $35.00 と $7.50 です。出力トークンの課金はどちらの場合も変わりません:
| バッチ構成 | 運用結果 |
|---|---|
| 強フィルタ API (3 回リトライ) | 手動修正が必須 |
| キャッシュなし単一行呼び出し | 低速なうえ、呼び出しのたびに用語集分にも通常の入力単価がかかる |
| bf16.ai キャッシュ併用構成 | そのまま出荷可能 |
5. 10 万行規模のバッチを回す前の 4 つの鉄則
system先頭に動的タイムスタンプを入れない(プレフィックスキャッシュのヒット率を高く保つため)。- 1 リクエストあたり
15〜25行にチャンク分割する。 - ワーカー再送時は必ず
Idempotency-Keyを付与する。 - プレースホルダ一致と UI 文字数上限をコードで自動検証する。