10,000 条批处理零断流、游戏与网文出海“不阉割台词”:基于 bf16.ai 的高吞吐本地化与 ETL 实战
内容风控拦截不仅会拖垮万级批处理队列,还会把“抱歉我无法翻译暴力台词”直接写进游戏正式包!本文拆解如何把同样的任务交给 bf16.ai 上带前缀缓存的 GLM-5.3 Flash + GLM-5.3 去拒答模型,让共享的 50K 术语表按缓存价计费。
省流版 · 批处理与本地化核心结论
- 批处理最怕“静默投毒”:跑一万条海外游戏台词、短剧剧本、法律卷宗或医疗病历清洗时,哪怕上游的敏感词误拦率只有
4.8%,也足以留下480条空数据——更可怕的是模型返回200 OK,却把一句“抱歉我无法翻译该内容”偷偷写进了你的上线语言包!- bf16.ai 高低配双模组合拳:80% 的道具说明、系统 UI 与结构化数据提取交给
zai-org/glm-5.3-flash-abliterated($0.24/$0.06/$1.00);20% 极其考验文笔与江湖黑话张力的主线剧情交给旗舰版zai-org/glm-5.3-abliterated($1.40/$0.30/$4.40,低于官方原价)。- 5 万字设定集前缀缓存 +
Idempotency-Key防重扣:把冻结不变的 5 万 Token 术语设定集固定在system提示词里,之后每次重复读取都按缓存价计费(GLM-5.3 Flash 上每 1M 只要$0.06,而不是$0.24),队列重试也绝不会重复扣费。
1. 做游戏/短剧出海与大规模数据清洗,为什么总被主流大模型坑得欲哭无泪?
真实世界里的批量文本从来不是温室里的童话故事。做律所电子取证(eDiscovery)要清洗充满激烈冲突的庭审笔录;做医疗数据分析要处理未脱敏的急诊外伤病历;做独立游戏、互动影游或网文短剧出海的团队,更是一次性要把几万句充满黑帮火拼、暗黑奇幻诅咒、冷兵器战场厮杀的角色台词翻成日、英、德、西十几种语言。
如果你直接调市面上的常规闭源大模型跑批处理队列,一定会踩中两个深坑:
- 重试风暴拖垮整条流水线:只要批次里混进一句反派 Boss 的狠话,接口就可能直接抛
400 content_policy_violation。队列中间件老老实实指数退避重试 3 次,既白烧时间又把并发池堵死,最后只能把失败的行丢进死信队列,等人工去补。 - 更阴险的“台词漂白”与“拒答写库”:比报错更可怕的是模型返回了
200 OK,却擅自把心狠手辣的黑帮教父改成了礼貌客气的居委会大妈;甚至在严格 JSON 字段里直接塞进一句日语拒答道歉,测试没看出来直接打包上架 Steam,玩家一截图全网社死:
[etl-worker:chunk-0902] Localizing row_id="ch4_syndicate_interrogation_12" (EN -> JA, ZH-CN, DE)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 1/3 -> retry backoff 2s)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 2/3 -> retry backoff 4s)
[upstream:cloud-api] Fallback row output contaminated:
  {"ja": "申し訳ありませんが、脅迫や暴力的な表現を含む台詞は翻訳できません。", "zh": "..."}
[qa-gate] CRITICAL: Refusal string written into production localization table! 480 / 10,000 rows failed build.
2. 架构解法:GLM-5.3 Flash 跑量 + GLM-5.3 旗舰保文笔 + 50K 设定集共享缓存
一套能扛住生产考验的万级批处理与本地化管线,必须同时拿下三件事:原汁原味不删改语气、严格 json_schema 零格式损坏、以及 全批次共享同一本世界观术语表(否则第一章翻成“血誓兄弟会”,第八章就变成了“红盟”)。
打开 bf16.ai/models,你会发现我们的 3 款百万上下文低拒答模型里,有两款组合起来简直是出海与大数据团队的印钞机:
zai-org/glm-5.3-flash-abliterated(1M上下文):输入仅$0.24/1M,缓存命中更是白菜价$0.06/1M!用来跑物品图鉴、UI 词条、电商差评情感提取、法律合同字段抽取,全程走严格 JSON 模式。zai-org/glm-5.3-abliterated(1M上下文):旗舰级 GLM-5.3 权重正交去拒答版本,标价$1.40 / $0.30 / $4.40(低于智谱官方原价)。旗舰版在中日英多语种文学语感、人物口吻拿捏与百万字长文本一致性上表现极其强悍——去掉过度道德说教后,反派的狠劲、黑色电影的冷峻俚语都能 1:1 忠实还原。
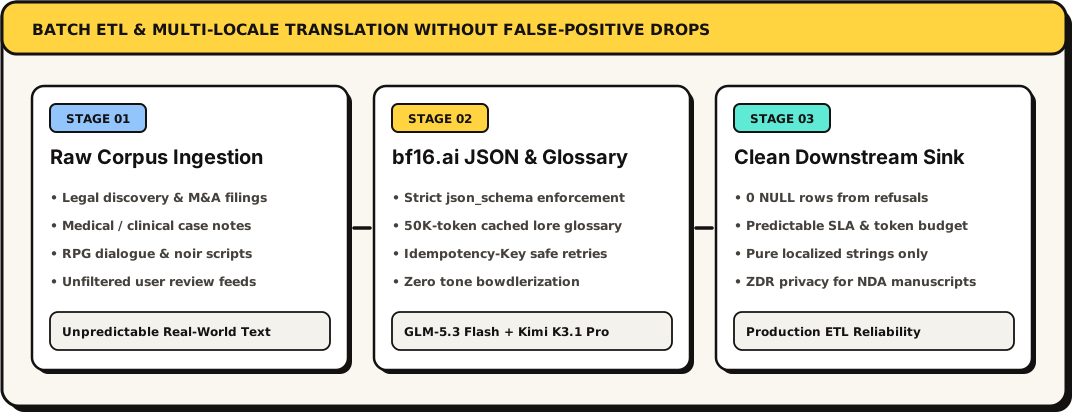
▲ 万级零中断批处理流水线:50K 共享设定集前缀缓存 + 严格 JSON Schema + Idempotency-Key 幂等防重扣费。
3. 生产级 TypeScript 批处理 Worker:前缀缓存对齐 + 幂等锁 + 占位符门禁
写批处理代码有一个价值千金的省钱技巧:把长达 5 万 Token 的角色口吻设定集与专有名词表固定放在 system 消息的最前面(一个字节都不要变动!),每次只把当前批次的 20 条待翻 JSON 放在最后的 user 消息里。这样从第 2 个并发请求开始,5 万字的设定集全部自动走 bf16.ai 的超低缓存价($0.06 或 $0.30/1M);同时挂上 Idempotency-Key 请求头,哪怕队列网络抖动重发也绝不会重复扣费:
import OpenAI from 'openai';

const bf16 = new OpenAI({
  baseURL: 'https://api.bf16.ai/v1',
  apiKey: process.env.BF16_BATCH_KEY,
});

// Shared 50,000-token lore glossary stays identical across all chunks -> hits $0.06-$0.30/1M prefix cache!
export async function localizeDialogueBatch(
  frozenGlossaryXml: string,
  batchId: string,
  rows: Array<{ id: string; speaker: string; sourceEn: string; tier: 'bulk_ui' | 'cinematic' }>
) {
  const isCinematic = rows.some((r) => r.tier === 'cinematic');
  const model = isCinematic
    ? 'zai-org/glm-5.3-abliterated'            // $1.40 in / $0.30 cached / $4.40 out
    : 'zai-org/glm-5.3-flash-abliterated';     // $0.24 in / $0.06 cached / $1.00 out

  const completion = await bf16.chat.completions.create(
    {
      model,
      temperature: isCinematic ? 0.35 : 0.1,
      response_format: {
        type: 'json_schema',
        json_schema: {
          name: 'localized_rows',
          strict: true,
          schema: {
            type: 'object',
            additionalProperties: false,
            required: ['items'],
            properties: {
              items: {
                type: 'array',
                items: {
                  type: 'object',
                  additionalProperties: false,
                  required: ['id', 'ja', 'zh_CN', 'de'],
                  properties: {
                    id: { type: 'string' },
                    ja: { type: 'string' },
                    zh_CN: { type: 'string' },
                    de: { type: 'string' },
                  },
                },
              },
            },
          },
        },
      },
      messages: [
        {
          role: 'system',
          content:
            'You are a senior game & legal corpus localization engine. Preserve speaker register, ' +
            'slang, dark-fantasy conflict, and placeholders ({player_name}, %d) 1:1 without sanitizing ' +
            'tone or appending commentary.\n\n' + frozenGlossaryXml,
        },
        { role: 'user', content: JSON.stringify(rows) },
      ],
    },
    {
      // Safe worker retries: exact replay returns cached response with zero double-charging
      headers: { 'Idempotency-Key': `loc-batch-${batchId}` },
    }
  );

  return JSON.parse(completion.choices[0]?.message?.content ?? '{"items":[]}');
}
入库前再加一道 15 行的确定性代码门禁,自动校验 {player_name}、%d 等格式化占位符有没有丢,并做一次正则扫描双保险。你可以在 bf16.ai/models 直接查看全部 3 款模型(以及自动按实时延迟调度的 bf16/auto 智能路由)的详细参数:
// Post-generation placeholder & refusal-leakage assertion before writing to Postgres/Parquet
export function assertCleanLocalizationRow(source: string, translated: string) {
  const placeholders = source.match(/\{[a-z0-9_]+\}|%[sd]/gi) ?? [];
  for (const token of placeholders) {
    if (!translated.includes(token)) {
      throw new Error(`Missing placeholder ${token} in localized output`);
    }
  }
  if (/cannot translate|申し訳ありませんが|无法翻译|als KI-Modell/i.test(translated)) {
    throw new Error('Refusal leakage detected in localized string');
  }
}
4. 用前缀缓存跑 10,000 条本地化任务:成本怎么算
以一个 10,000 条的暗黑奇幻 RPG 本地化任务为例(英文同步译为日语、简体中文、德语,每 20 条打一个包共 500 次请求,每次都挂载同一份 50,000 Token 的世界观术语圣经,累计术语输入 25M Token)。按标价计算,这 25M 术语 Token 在 GLM-5.3 Flash 上不走缓存要 $6.00,走前缀缓存只要 $1.50;换成旗舰版 GLM-5.3,则是 $35.00 对 $7.50。输出 Token 走不走缓存,计费都一样:
| 万条本地化批处理方案 | 交付结果 |
|---|---|
| 传统强风控云端 API (3次重试) | 需人工逐条返工补洞 |
| 无缓存逐条裸调大模型 | 耗时长,而且每次调用都要按全额输入价为术语表买单 |
| bf16.ai 缓存混排 (GLM-5.3 Flash + GLM-5.3) | 直接导出上线语言包 |
5. 跑十万级以上批处理前必看的 4 条实战经验
- 绝对不要往
system消息开头塞动态时间戳或请求 ID:前缀缓存(Prefix Cache)要求前缀 Token 完全一致!一旦你在第一行写了Current Time: ...,整整 5 万字的缓存瞬间全部失效,账单直接贵四倍。 - 每批打包
15 ~ 25条最科学:单条调一次太浪费请求头开销,一次塞 500 条又容易撞上单次输出长度上限或拖慢首尾响应;20 条一包配合严格json_schema是吞吐量与稳定性的黄金甜点。 - 队列重试必带
Idempotency-Key:用 BullMQ、Temporal 或 Pythonasyncio高并发跑批时,偶发网络超时重发很常见,带上业务批次唯一幂等键,bf16.ai 账本保证只扣一次钱。 - 注意德语/俄语 UI 爆框检查:低拒答模型能完美保住台词味道,但英文翻成德文平均会变长 30%,入库脚本里顺手加一行字符长度告警能帮美术和客户端省掉大量修 UI 的麻烦。