Pipeline batch da 10.000 righe senza interruzioni e localizzazione fedele di videogiochi su bf16.ai
Come i blocchi dei filtri di contenuto rovinano i job ETL e censurano i dialoghi narrativi — e come eseguire gli stessi job con GLM-5.3 Flash e GLM-5.3 su bf16.ai, con il glossario condiviso fatturato alla tariffa dell’input in cache.
TL;DR · Ingegneria Batch e Localizzazione
- Inquinamento silenzioso dei dati: Su
10.000righe legali, cliniche o RPG, basterebbe un4,8%di rifiuti per lasciare480buchi o scrivere le scuse del modello direttamente nel database di produzione.- Routing a due livelli su bf16.ai:
zai-org/glm-5.3-flash-abliterated($0.24/$0.06/$1.00) per UI/ETL ad alto volume ezai-org/glm-5.3-abliterated($1.40/$0.30/$4.40, sotto il listino ufficiale) per i dialoghi principali.- Glossario da 50K in cache +
Idempotency-Key: Con un glossario terminologico da50Ktoken fissato nel prompt di sistema, ogni lettura successiva viene fatturata alla tariffa in cache ($0.06invece di$0.24per 1M su GLM-5.3 Flash), evitando doppi addebiti nei retry.
1. Due modi in cui le API standard rovinano ETL massivi e localizzazione
Atti giudiziari, referti di pronto soccorso e copioni dark-fantasy contengono inevitabilmente linguaggio crudo. Le API consumer innescano tempeste di errori 400 content_policy_violation oppure edulcorano arbitrariamente il tono dei personaggi inserendo frasi di rifiuto dentro il JSON:
[etl-worker:chunk-0902] Localizing row_id="ch4_syndicate_interrogation_12" (EN -> JA, ZH-CN, DE)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 1/3 -> retry backoff 2s)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 2/3 -> retry backoff 4s)
[upstream:cloud-api] Fallback row output contaminated:
  {"ja": "申し訳ありませんが、脅迫や暴力的な表現を含む台詞は翻訳できません。", "zh": "..."}
[qa-gate] CRITICAL: Refusal string written into production localization table! 480 / 10,000 rows failed build.
2. Architettura batch con cache di prefisso: GLM-5.3 Flash + GLM-5.3
Su bf16.ai/models due modelli abliterated con 1M di contesto lavorano in coppia:
zai-org/glm-5.3-flash-abliterated(1Mcontesto): Input in cache a soli$0.06/1Mper estrazione JSON massiva e stringhe UI.zai-org/glm-5.3-abliterated(1Mcontesto): Mantiene intatti gergo, registri letterari e tensione drammatica ($1.40/$0.30/$4.40).
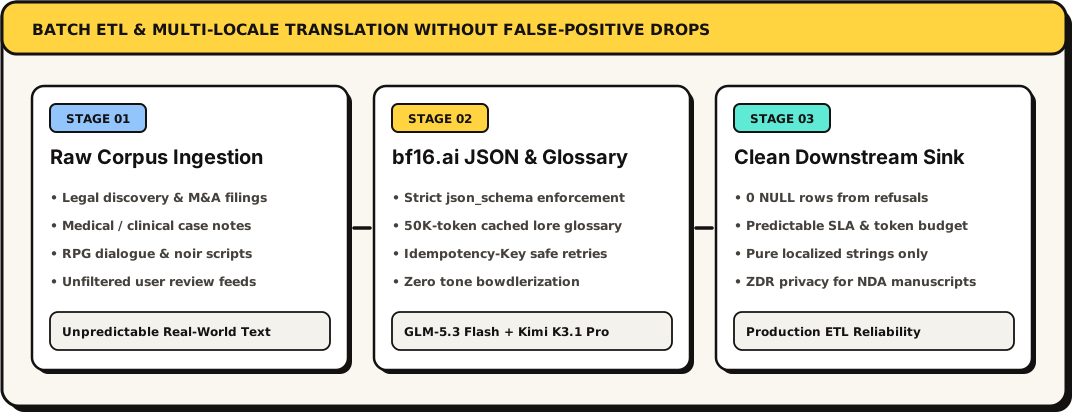
▲ Pipeline batch zero abort: Glossario condiviso da 50K in cache + JSON Schema rigoroso + Idempotency-Key.
3. Worker TypeScript di produzione con Idempotency-Key e controllo placeholder
Mantieni il glossario da 50.000 token fisso all’inizio del messaggio system per massimizzare la cache di prefisso e allega Idempotency-Key a ogni chunk:
import OpenAI from 'openai';

const bf16 = new OpenAI({
  baseURL: 'https://api.bf16.ai/v1',
  apiKey: process.env.BF16_BATCH_KEY,
});

// Shared 50,000-token lore glossary stays identical across all chunks -> hits $0.06-$0.30/1M prefix cache!
export async function localizeDialogueBatch(
  frozenGlossaryXml: string,
  batchId: string,
  rows: Array<{ id: string; speaker: string; sourceEn: string; tier: 'bulk_ui' | 'cinematic' }>
) {
  const isCinematic = rows.some((r) => r.tier === 'cinematic');
  const model = isCinematic
    ? 'zai-org/glm-5.3-abliterated'            // $1.40 in / $0.30 cached / $4.40 out
    : 'zai-org/glm-5.3-flash-abliterated';     // $0.24 in / $0.06 cached / $1.00 out

  const completion = await bf16.chat.completions.create(
    {
      model,
      temperature: isCinematic ? 0.35 : 0.1,
      response_format: {
        type: 'json_schema',
        json_schema: {
          name: 'localized_rows',
          strict: true,
          schema: {
            type: 'object',
            additionalProperties: false,
            required: ['items'],
            properties: {
              items: {
                type: 'array',
                items: {
                  type: 'object',
                  additionalProperties: false,
                  required: ['id', 'ja', 'zh_CN', 'de'],
                  properties: {
                    id: { type: 'string' },
                    ja: { type: 'string' },
                    zh_CN: { type: 'string' },
                    de: { type: 'string' },
                  },
                },
              },
            },
          },
        },
      },
      messages: [
        {
          role: 'system',
          content:
            'You are a senior game & legal corpus localization engine. Preserve speaker register, ' +
            'slang, dark-fantasy conflict, and placeholders ({player_name}, %d) 1:1 without sanitizing ' +
            'tone or appending commentary.\n\n' + frozenGlossaryXml,
        },
        { role: 'user', content: JSON.stringify(rows) },
      ],
    },
    {
      // Safe worker retries: exact replay returns cached response with zero double-charging
      headers: { 'Idempotency-Key': `loc-batch-${batchId}` },
    }
  );

  return JSON.parse(completion.choices[0]?.message?.content ?? '{"items":[]}');
}
Verifica sempre i placeholder ({player_name}, %d) prima del salvataggio. Puoi confrontare finestre di contesto e tariffe in cache dei tre modelli direttamente su bf16.ai/models:
// Post-generation placeholder & refusal-leakage assertion before writing to Postgres/Parquet
export function assertCleanLocalizationRow(source: string, translated: string) {
  const placeholders = source.match(/\{[a-z0-9_]+\}|%[sd]/gi) ?? [];
  for (const token of placeholders) {
    if (!translated.includes(token)) {
      throw new Error(`Missing placeholder ${token} in localized output`);
    }
  }
  if (/cannot translate|申し訳ありませんが|无法翻译|als KI-Modell/i.test(translated)) {
    throw new Error('Refusal leakage detected in localized string');
  }
}
4. Calcolo dei costi di un job di localizzazione da 10.000 righe con cache di prefisso
Prendiamo un job di localizzazione RPG dark-fantasy da 10.000 battute (EN -> JA + zh-CN + DE, 20 battute per blocco = 500 chiamate API, ciascuna preceduta da una bibbia narrativa da 50.000 token = 25M token di glossario cumulativi). A prezzi di listino, quei 25M token di glossario costano $6.00 senza cache su GLM-5.3 Flash ma $1.50 dalla cache di prefisso — e $35.00 contro $7.50 su GLM-5.3. I token di output hanno lo stesso prezzo in entrambi i casi:
| Configurazione Pipeline | Esito SLA |
|---|---|
| API filtrata rigida (3x retry) | Bonifica manuale necessaria |
| Chiamate singole senza cache | Lento, e a ogni chiamata paga il glossario alla tariffa di input piena |
| bf16.ai con Cache (GLM-5.3 Flash + GLM-5.3) | Pronto al rilascio |
5. 4 regole ingegneristiche prima di elaborare oltre 100K righe
- Mantieni il prefisso
systemidentico byte per byte (niente timestamp dinamici in testa). - Raggruppa
15–25righe per singola richiesta JSON. - Invia sempre
Idempotency-Keydai worker di coda. - Controlla placeholder ed espansione della lunghezza testo per UI in tedesco o russo.