Pipelines em lote de 10.000 linhas sem quedas e localização fiel de jogos na bf16.ai
Como bloqueios do filtro de conteúdo corrompem tabelas ETL e descaracterizam diálogos de jogos — e como rodar os mesmos jobs em modelos abliterated com cache de prefixo na bf16.ai, com o glossário compartilhado cobrado pela tarifa de cache.
TL;DR · Engenharia de Lote e Localização
- Contaminação silenciosa: Em um lote de
10.000linhas jurídicas, clínicas ou de RPG, uma taxa de recusa de apenas4,8%já deixaria480linhas perdidas — ou, pior, gravaria pedidos de desculpas da IA dentro do jogo.- Roteamento duplo na bf16.ai:
zai-org/glm-5.3-flash-abliterated($0.24/$0.06/$1.00) para strings em massa ezai-org/glm-5.3-abliterated($1.40/$0.30/$4.40, abaixo da tabela oficial) para diálogos principais.- Glossário de 50K em cache +
Idempotency-Key: Fixar um glossário congelado de50Ktokens no prompt de sistema faz com que cada releitura seja cobrada pela tarifa de cache ($0.06em vez de$0.24por 1M no GLM-5.3 Flash), sem cobrança dupla em retentativas.
1. Duas maneiras pelas quais APIs comuns estragam ETL massivo e localização
Depoimentos judiciais, prontuários clínicos e roteiros de fantasia sombria contêm conflitos reais. APIs alinhadas para chat disparam tempestades de erro 400 content_policy_violation ou suavizam por conta própria a fala do antagonista, chegando a inserir mensagens de recusa dentro do JSON final:
[etl-worker:chunk-0902] Localizing row_id="ch4_syndicate_interrogation_12" (EN -> JA, ZH-CN, DE)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 1/3 -> retry backoff 2s)
[upstream:cloud-api] HTTP 400 content_policy_violation (attempt 2/3 -> retry backoff 4s)
[upstream:cloud-api] Fallback row output contaminated:
  {"ja": "申し訳ありませんが、脅迫や暴力的な表現を含む台詞は翻訳できません。", "zh": "..."}
[qa-gate] CRITICAL: Refusal string written into production localization table! 480 / 10,000 rows failed build.
2. Arquitetura Batch com cache de prefixo: GLM-5.3 Flash + GLM-5.3
Em bf16.ai/models, dois modelos abliterated de 1M de contexto formam a dupla ideal:
zai-org/glm-5.3-flash-abliterated(1Mde contexto): Entrada em cache a apenas$0.06/1Mpara extração JSON e itens de UI.zai-org/glm-5.3-abliterated(1Mde contexto): Preserva gírias, nuances literárias e intensidade dramática ($1.40/$0.30/$4.40).
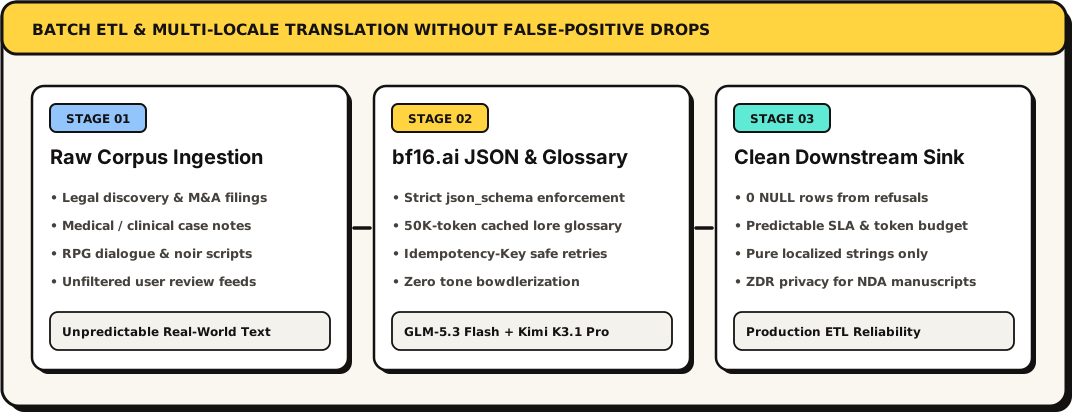
▲ Pipeline em lote sem falhas: Glossário de 50K em cache + JSON Schema estrito + proteção Idempotency-Key.
3. Worker TypeScript de produção com Idempotency-Key e trava de placeholders
Mantenha o glossário de 50.000 tokens estático no início da mensagem system para atingir o cache de prefixo e envie Idempotency-Key por bloco:
import OpenAI from 'openai';

const bf16 = new OpenAI({
  baseURL: 'https://api.bf16.ai/v1',
  apiKey: process.env.BF16_BATCH_KEY,
});

// Shared 50,000-token lore glossary stays identical across all chunks -> hits $0.06-$0.30/1M prefix cache!
export async function localizeDialogueBatch(
  frozenGlossaryXml: string,
  batchId: string,
  rows: Array<{ id: string; speaker: string; sourceEn: string; tier: 'bulk_ui' | 'cinematic' }>
) {
  const isCinematic = rows.some((r) => r.tier === 'cinematic');
  const model = isCinematic
    ? 'zai-org/glm-5.3-abliterated'            // $1.40 in / $0.30 cached / $4.40 out
    : 'zai-org/glm-5.3-flash-abliterated';     // $0.24 in / $0.06 cached / $1.00 out

  const completion = await bf16.chat.completions.create(
    {
      model,
      temperature: isCinematic ? 0.35 : 0.1,
      response_format: {
        type: 'json_schema',
        json_schema: {
          name: 'localized_rows',
          strict: true,
          schema: {
            type: 'object',
            additionalProperties: false,
            required: ['items'],
            properties: {
              items: {
                type: 'array',
                items: {
                  type: 'object',
                  additionalProperties: false,
                  required: ['id', 'ja', 'zh_CN', 'de'],
                  properties: {
                    id: { type: 'string' },
                    ja: { type: 'string' },
                    zh_CN: { type: 'string' },
                    de: { type: 'string' },
                  },
                },
              },
            },
          },
        },
      },
      messages: [
        {
          role: 'system',
          content:
            'You are a senior game & legal corpus localization engine. Preserve speaker register, ' +
            'slang, dark-fantasy conflict, and placeholders ({player_name}, %d) 1:1 without sanitizing ' +
            'tone or appending commentary.\n\n' + frozenGlossaryXml,
        },
        { role: 'user', content: JSON.stringify(rows) },
      ],
    },
    {
      // Safe worker retries: exact replay returns cached response with zero double-charging
      headers: { 'Idempotency-Key': `loc-batch-${batchId}` },
    }
  );

  return JSON.parse(completion.choices[0]?.message?.content ?? '{"items":[]}');
}
Valide placeholders ({player_name}, %d) antes de gravar no banco. Compare as janelas de contexto e as tarifas de cache dos 3 modelos em bf16.ai/models:
// Post-generation placeholder & refusal-leakage assertion before writing to Postgres/Parquet
export function assertCleanLocalizationRow(source: string, translated: string) {
  const placeholders = source.match(/\{[a-z0-9_]+\}|%[sd]/gi) ?? [];
  for (const token of placeholders) {
    if (!translated.includes(token)) {
      throw new Error(`Missing placeholder ${token} in localized output`);
    }
  }
  if (/cannot translate|申し訳ありませんが|无法翻译|als KI-Modell/i.test(translated)) {
    throw new Error('Refusal leakage detected in localized string');
  }
}
4. Calculando o custo de um job de localização de 10.000 linhas com cache de prefixo
Considere a localização de 10.000 strings de um RPG de fantasia sombria (EN -> JA + zh-CN + DE, 20 strings por chamada × 500 chamadas, cada uma precedida por uma bíblia de 50K tokens = 25M tokens de glossário acumulados). Pelos preços de tabela, esses 25M tokens de glossário custam $6.00 sem cache no GLM-5.3 Flash, mas $1.50 quando lidos do cache de prefixo — e $35.00 contra $7.50 no GLM-5.3. Os tokens de saída custam o mesmo nos dois casos:
| Configuração da Pipeline | Resultado |
|---|---|
| API com filtro rígido (3x retry) | Retrabalho manual |
| Chamadas sem cache de prefixo | Lento, e paga a tarifa cheia de entrada pelo glossário em toda chamada |
| bf16.ai com Cache (GLM-5.3 Flash + GLM-5.3) | Pronto para produção |
5. 4 regras de engenharia antes de rodar lotes acima de 100K linhas
- Mantenha o prefixo
systemidêntico byte a byte (sem timestamps variáveis no topo). - Agrupe de
15a25linhas por requisição JSON. - Envie sempre
Idempotency-Keynos workers de fila. - Valide placeholders e expansão de caracteres em idiomas como alemão e russo.